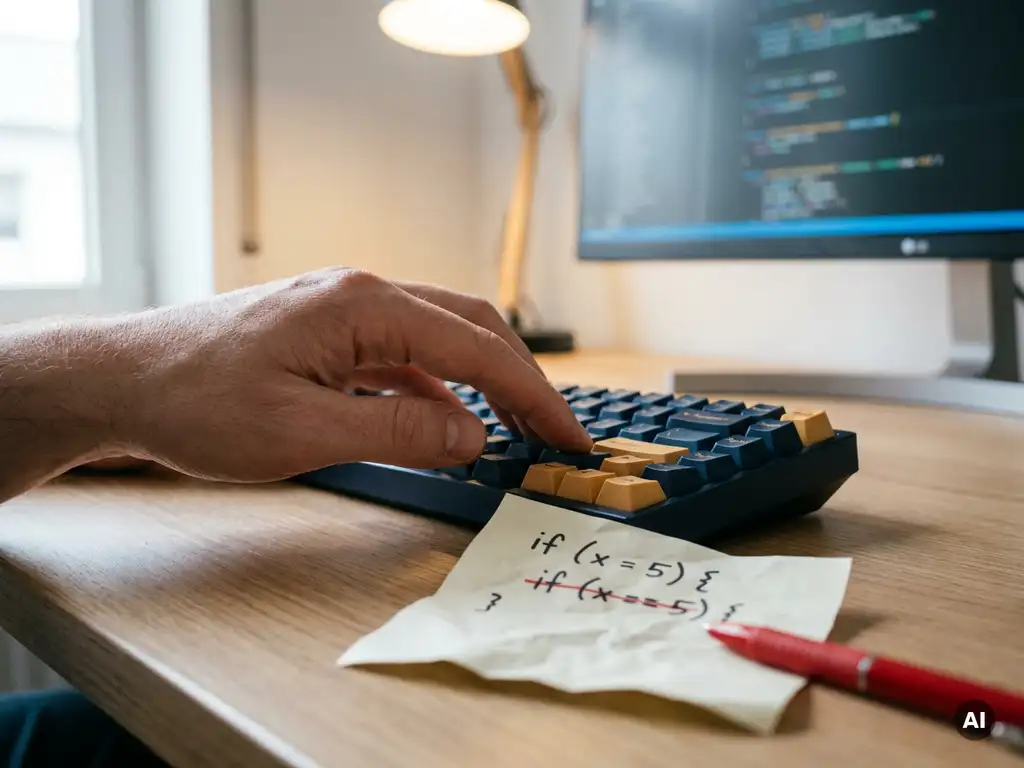
De beste aanpak voor hallucinaties en fouten in AI-gegenereerde code is een gelaagde reviewstrategie: combineer geautomatiseerde validatie met gerichte menselijke beoordeling door developers die begrijpen waar AI-tools structureel de mist in gaan. AI-codetools zoals GitHub Copilot of Cursor genereren code die er syntactisch correct uitziet, maar semantisch onjuist kan zijn. Dat verschil is precies wat ze gevaarlijk maakt. De secties hieronder behandelen de meest voorkomende valkuilen, detectiemethoden en praktische guardrails die je vandaag in je workflow kunt inbouwen.
Waarom produceert AI-code fouten die er correct uitzien?
AI-codetools produceren fouten die er correct uitzien omdat ze zijn getraind om waarschijnlijke code te genereren, niet om correcte code te redeneren. Een large language model voorspelt de volgende tokens op basis van patronen in trainingsdata. Het begrijpt de intentie achter jouw code niet; het simuleert die intentie op basis van statistische associaties.
Dit heeft een concreet gevolg: de gegenereerde code is syntactisch valide, compileert zonder foutmelding en ziet er op het eerste gezicht logisch uit. Maar de onderliggende logica kan subtiel afwijken van wat je bedoelt. Een functie retourneert de verkeerde waarde in een randgeval. Een authenticatiecheck wordt omgedraaid. Een database-query haalt meer rijen op dan bedoeld.
Het probleem wordt versterkt doordat AI-tools geen toegang hebben tot de volledige context van jouw systeem. Ze zien een fragment, een bestand, soms een repository. Maar ze kennen jouw domeinlogica, jouw datamodel en jouw operationele randvoorwaarden niet tenzij je die expliciet meegeeft. En zelfs dan is er geen garantie dat het model die context correct toepast.
Wat zijn de meest voorkomende soorten AI-codefouten?
De meest voorkomende soorten AI-codefouten vallen in vier categorieën: hallucinaties van niet-bestaande API’s of methoden, logische fouten in randgevallen, beveiligingsproblemen door verouderde patronen, en subtiele type- of scope-fouten die pas in productie zichtbaar worden.
- Hallucinaties: Het model genereert aanroepen naar functies of libraries die niet bestaan, of die in een andere versie bestonden dan je gebruikt.
- Randgevalfouten: De gegenereerde logica werkt voor het happy path, maar faalt bij lege arrays, null-waarden, negatieve getallen of onverwachte invoer.
- Verouderde beveiligingspatronen: AI-tools zijn getraind op historische code, inclusief code met bekende kwetsbaarheden. Ze reproduceren soms SQL-injectierisico’s, onveilige hashing of gebrekkige inputvalidatie.
- Scope- en type-fouten: Variabelen worden buiten hun bedoelde scope gebruikt, of typen worden impliciet omgezet op manieren die pas bij runtime problemen geven.
Wat deze fouten zo lastig maakt, is dat ze niet opvallen bij een vluchtige blik. Ze vereisen actieve, gerichte review, niet het soort review dat je doet als je ervan uitgaat dat de code al grotendeels klopt.
Hoe detecteer je hallucinaties in AI-gegenereerde code?
Hallucinaties in AI-gegenereerde code detecteer je door elke externe referentie in de gegenereerde code expliciet te verifiëren: controleer of de gebruikte library-versie bestaat, of de aangeroepen methode in de officiële documentatie staat, en of de functiesignatuur overeenkomt met wat je in je eigen codebase hebt gedefinieerd.
In de praktijk betekent dit een aantal concrete stappen. Controleer bij elke import of dependency of de package daadwerkelijk in je lockfile staat. Zoek elke onbekende methode-aanroep op in de officiële documentatie van de betreffende library, niet in de AI-output zelf. Schrijf tests die de randgevallen afdekken die de AI niet heeft meegenomen, en laat die tests falen voordat je ze groen maakt.
Statische analyse helpt ook, maar is niet voldoende op zichzelf. Tools als ESLint, Pylint of SonarQube vangen type-fouten en ongedefinieerde referenties, maar missen domeinspecifieke logicafouten. De combinatie van statische analyse plus gerichte menselijke review van de bedrijfslogica is de meest betrouwbare aanpak.
Welke reviewstrategie werkt het best voor AI-code in een team?
De meest effectieve reviewstrategie voor AI-gegenereerde code is een tweefasige aanpak: eerst geautomatiseerde validatie via linting, tests en statische analyse, daarna een gerichte menselijke review die zich specifiek richt op de logica, de randgevallen en de beveiligingsimplicaties, niet op de stijl of syntaxis.
Dat tweede deel is cruciaal. Traditionele code review is erop gericht om de reviewer te laten controleren of de code doet wat de schrijver bedoelde. Bij AI-gegenereerde code is de vraag anders: doet de code wat het systeem nodig heeft? Die vraag vereist dat de reviewer de context begrijpt, niet alleen de code.
Praktische richtlijnen voor teams:
- Markeer AI-gegenereerde code expliciet in pull requests, zodat reviewers weten dat extra aandacht vereist is.
- Schrijf tests voor de AI-code voordat je die accepteert, niet erna.
- Laat de developer die de AI-code heeft gebruikt de logica mondeling toelichten tijdens review. Als die toelichting wankelt, is de code nog niet klaar.
- Voer een beveiligingsgerichte review uit op elke AI-gegenereerde code die authenticatie, autorisatie of data-opslag raakt.
- Gebruik pair review voor complexe AI-gegenereerde modules, waarbij één reviewer de functionaliteit beoordeelt en een tweede de architectuurfit.
Wanneer is AI-codegeneratie te riskant om te gebruiken?
AI-codegeneratie is te riskant zonder aanvullende maatregelen bij code die raakt aan beveiliging, compliance, financiële berekeningen of kritieke infrastructuur. In die domeinen zijn de gevolgen van subtiele fouten groot genoeg dat de snelheidswinst van AI-tools niet opweegt tegen het risico van ongecontroleerde output.
Concreet: gebruik AI-codegeneratie niet als primaire bron voor authenticatielogica, encryptie-implementaties, betalingsverwerking of code die moet voldoen aan regelgeving zoals de AVG of PCI-DSS, tenzij je beschikt over een robuust review- en testproces dat die output systematisch valideert.
Dat betekent niet dat AI-tools in die contexten geen rol spelen. Ze kunnen nuttig zijn voor boilerplate, documentatie, testgeneratie en het verkennen van oplossingsrichtingen. Maar de uiteindelijke implementatie vereist een developer die de output volledig begrijpt en verantwoordelijkheid neemt voor de correctheid, niet iemand die de suggestie accepteert omdat die er aannemelijk uitziet.
Hoe bouw je guardrails in je AI-codeworkflow?
Effectieve guardrails in een AI-codeworkflow bestaan uit een combinatie van technische controles en teamnormen die samen voorkomen dat ongevalideerde AI-output de productiecodebase bereikt. De technische kant en de menselijke kant versterken elkaar, maar geen van beide werkt alleen.
Op technisch niveau zijn dit de meest effectieve guardrails:
- Verplichte CI-pipeline met statische analyse, unit tests en integratietests die draaien op elke pull request
- Code coverage-drempels die voorkomen dat ongeteste code wordt gemerged
- Dependency scanning om gehallucineerde of verouderde packages te signaleren
- SAST-tools (Static Application Security Testing) voor beveiligingsrisico’s in gegenereerde code
Op teamniveau zijn normen minstens zo belangrijk: een expliciete afspraak dat AI-code altijd wordt gemarkeerd, dat de developer die de code indient aantoonbaar begrijpt wat die doet, en dat tests worden geschreven vóór acceptatie. Zonder die normen worden de technische guardrails omzeild door tijdsdruk.
Hoe verandert AI-codegeneratie de rol van de developer?
AI-codegeneratie verschuift de rol van de developer van schrijver naar beoordelaar. De developer schrijft minder regels code zelf, maar neemt meer verantwoordelijkheid voor het beoordelen, valideren en sturen van AI-output. Dat vereist een dieper begrip van architectuur, domeinlogica en beveiligingsprincipes, niet minder.
Dit is precies het verschil tussen een developer die AI gebruikt om sneller te typen, en een developer die AI gebruikt om sneller tot een beter doordachte oplossing te komen. De eerste verplaatst het risico naar later. De tweede gebruikt AI als versneller van zijn eigen redenering, terwijl hij de regie houdt over kwaliteit en architectuur.
Voor teams betekent dit dat senioriteit anders wordt gewogen. Een junior developer die AI-output niet kritisch kan beoordelen, introduceert risico’s die pas later zichtbaar worden. Een senior developer die AI-natief werkt, kan diezelfde tools inzetten om sneller te leveren zonder in te leveren op betrouwbaarheid. Het onderscheid zit niet in of iemand AI gebruikt, maar in hoe en met welk begrip.
Hoe SharpMinds helpt met AI-codekwaliteit en teamversterking
De uitdagingen rondom AI-gegenereerde code, van hallucinaties tot reviewprocessen tot guardrails, zijn uiteindelijk geen toolingproblemen. Het zijn mensen-problemen. De kwaliteit van je AI-codeworkflow staat of valt met developers die weten wanneer ze een AI-suggestie vertrouwen, wanneer ze die verwerpen, en hoe ze dat proces inbedden in een robuust teamproces.
SharpMinds selecteert AI-native developers die dit onderscheid aantoonbaar beheersen. Dat betekent concreet:
- Screening op AI-vaardigheden naast technische expertise en culturele fit
- Beoordeling van hoe kandidaten AI-tools inzetten in hun dagelijkse workflow, inclusief waar ze de grens trekken
- Focus op senior developers die snel integreren in jouw bestaande manier van werken en reviewprocessen
- Langdurige samenwerking waarbij developers onderdeel worden van jouw team, niet een tijdelijke toevoeging
Zo voeg je niet alleen capaciteit toe, maar ook kennis en werkwijzen die je bestaande team direct kunnen versterken. Wil je weten welke profielen passen bij jouw huidige delivery-uitdagingen? Neem contact op voor een vrijblijvend gesprek.
Veelgestelde vragen
Hoe weet ik als developer wanneer ik een AI-suggestie kan vertrouwen en wanneer niet?
Een goede vuistregel is: vertrouw een AI-suggestie alleen als je de output volledig kunt doorgronden en verantwoorden zonder de AI zelf te raadplegen. Als je de logica niet zelfstandig kunt uitleggen aan een collega, is de code nog niet klaar om te accepteren. Gebruik twijfel als signaal: als iets 'waarschijnlijk wel klopt', is dat precies het moment om dieper te reviewen, niet om door te gaan.
Welke concrete tools kan ik vandaag nog inzetten om AI-gegenereerde code automatisch te valideren?
Voor statische analyse zijn ESLint (JavaScript/TypeScript), Pylint of Ruff (Python) en SonarQube (meerdere talen) sterke startpunten. Voor beveiligingsspecifieke validatie zijn Semgrep en Snyk effectief, en voor dependency-hallucinaties helpt het om je lockfile-verificatie te automatiseren via tools als Dependabot of pip-audit. Combineer deze tools in je CI-pipeline zodat elke pull request automatisch door meerdere lagen validatie gaat voordat een menselijke reviewer ernaar kijkt.
Hoe ga ik om met tijdsdruk binnen een team dat AI-code snel wil shippen zonder reviewstappen over te slaan?
Tijdsdruk is de grootste vijand van een degelijk reviewproces, en dat is precies waarom guardrails technisch afgedwongen moeten worden in plaats van afhankelijk te zijn van discipline. Maak het onmogelijk om ongeteste of ongemarkeerde AI-code te mergen door CI-gates en branch-protectionregels. Zo wordt de reviewstap geen keuze, maar een vereiste, ongeacht de sprint-deadline.
Hoe train ik junior developers om AI-output kritisch te beoordelen in plaats van blind te accepteren?
De meest effectieve aanpak is het inbouwen van verplichte mondelinge toelichtingen tijdens code reviews: laat de junior developer de logica van de AI-code uitleggen zonder terug te kijken naar de output. Voeg hier pair reviews aan toe waarbij een senior developer specifiek doorvraagt op randgevallen en beveiligingsimplicaties. Dit versnelt het ontwikkelen van kritisch beoordelingsvermogen sneller dan documentatie of trainingen alleen.
Wat doe ik als AI-gegenereerde code al in productie is gegaan voordat het goed gereviewd werd?
Voer direct een gerichte audit uit op de betreffende code, met prioriteit voor secties die raken aan authenticatie, dataverwerking of externe API-aanroepen. Schrijf alsnog tests die de randgevallen afdekken en draai deze tegen de productiecodebase. Gebruik dit incident als aanleiding om technische guardrails alsnog in te voeren, en documenteer wat er misging zodat het team leert van het proces in plaats van alleen de symptomen op te lossen.
Zijn er specifieke programmeertalen of frameworks waarbij AI-codegeneratie betrouwbaarder of juist riskanter is?
AI-tools presteren over het algemeen betrouwbaarder in talen en frameworks die sterk vertegenwoordigd zijn in publieke trainingsdata, zoals Python, JavaScript en TypeScript met populaire frameworks als React of FastAPI. Riskanter wordt het bij niche-frameworks, interne DSL's, of snel evoluerende libraries waarbij de trainingsdata verouderd is en hallucinaties van niet-bestaande API's frequenter voorkomen. Controleer bij minder gangbare stacks altijd extra zorgvuldig elke externe referentie in de gegenereerde output.
Hoe documenteer ik in een codebase welke code AI-gegenereerd is, en waarom is dat belangrijk?
Een praktische aanpak is het gebruik van een standaard commit-tag of pull request-label, zoals 'ai-assisted', gecombineerd met een korte inline comment bij complexe AI-gegenereerde functies die aangeeft welk deel door AI is gegenereerd en hoe het is gevalideerd. Dit is belangrijk omdat toekomstige developers dan weten dat extra voorzichtigheid geboden is bij refactoring, en omdat het je reviewproces transparant maakt voor audits of compliance-checks.
Gerelateerde artikelen
- Wat zijn de verschillen tussen AI-native development in B2B en B2C software?
- Wat is het verschil tussen AI-assisted coding en AI-native development?
- Wat zijn de belangrijkste verschillen tussen nearshoring in Portugal en Oekraïne?
- Welke technische stack-overwegingen spelen mee bij het kiezen van een nearshore partner?
- Welke contractvormen werken het best bij nearshore IT-partnerships?