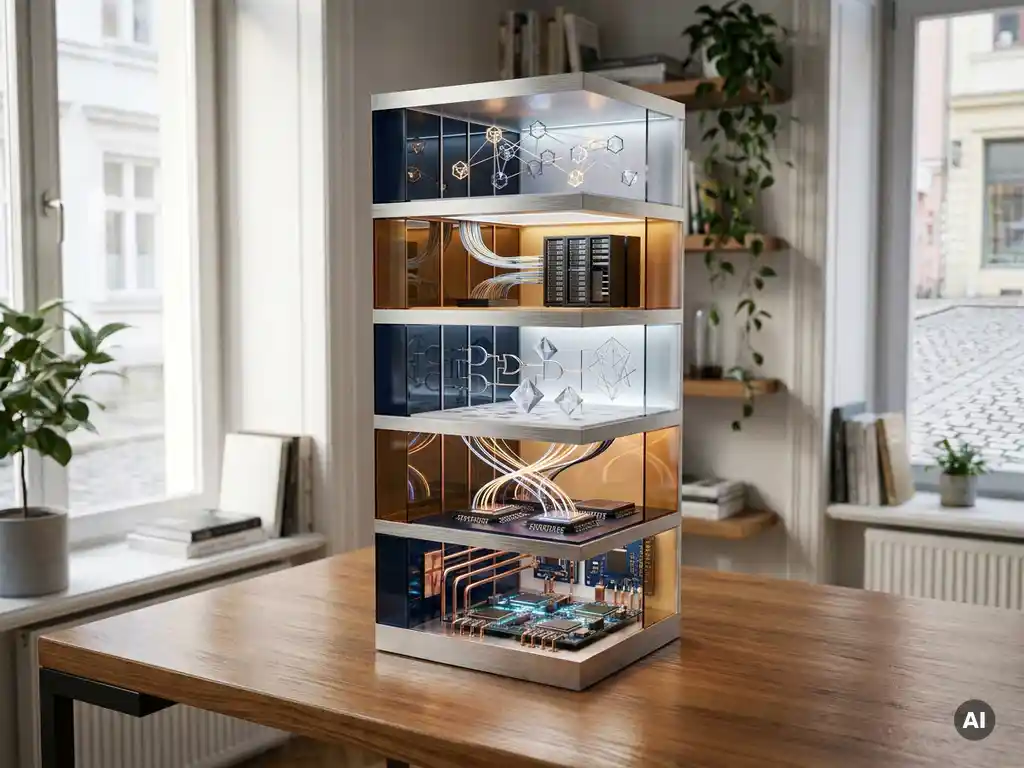
De 5-layer AI stack is een architectuurmodel dat beschrijft hoe AI-systemen zijn opgebouwd uit vijf opeenvolgende lagen: data, modellen, orkestratie, applicatie en interface. Elke laag heeft een eigen verantwoordelijkheid binnen het geheel. Dit model helpt technische teams om AI-implementaties gestructureerd op te zetten, verantwoordelijkheden te verdelen en architecturale keuzes bewust te maken. De vragen hieronder werken elke laag en de praktische toepassing ervan verder uit.
Uit welke lagen bestaat de 5-layer AI stack?
De 5-layer AI stack bestaat uit vijf functionele lagen die samen een compleet AI-systeem vormen: de datalaag, de modellaag, de orkestratielaag, de applicatielaag en de interfacelaag. Elke laag bouwt voort op de vorige en heeft een specifieke technische verantwoordelijkheid binnen de AI-architectuur.
- Laag 1 — Data: Ruwe data wordt verzameld, opgeslagen en voorbereid. Dit omvat databronnen, pipelines, feature stores en datakwaliteitsbeheer.
- Laag 2 — Model: Het trainen, finetunen of inzetten van machinelearningmodellen of large language models (LLM’s). Hier worden modelkeuzes gemaakt en versies beheerd.
- Laag 3 — Orkestratie: De logica die bepaalt hoe modellen worden aangeroepen, gecombineerd of gekoppeld aan externe tools en databronnen. Denk aan agent-frameworks en prompt-management.
- Laag 4 — Applicatie: De bedrijfslogica die AI-uitkomsten vertaalt naar bruikbare functionaliteit. Hier zit de integratie met bestaande systemen, API’s en workflows.
- Laag 5 — Interface: De laag waarmee eindgebruikers of andere systemen interageren: een chat-UI, een dashboard, een API-endpoint of een geautomatiseerde trigger.
Dit onderscheid is niet puur theoretisch. In de praktijk helpt het om te voorkomen dat teams verantwoordelijkheden door elkaar halen, wat leidt tot onbeheerbare codebases en moeilijk te debuggen systemen.
Hoe verhouden de lagen zich tot elkaar?
De lagen in de AI stack zijn sequentieel afhankelijk: elke laag ontvangt input van de laag eronder en levert output aan de laag erboven. Tegelijkertijd zijn ze logisch gescheiden, zodat je wijzigingen in één laag kunt doorvoeren zonder de volledige stack te hoeven herbouwen.
Een praktisch voorbeeld: stel je vervangt een open-source LLM door een API-call naar een commercieel model. Als de modellaag goed is geabstraheerd van de orkestratielaag, heeft die wijziging geen impact op de applicatielogica of de interface. Zonder die scheiding wordt elke modelwissel een risicovolle operatie door de hele codebase.
De orkestratielaag is hierin de meest verknoopte schakel: die communiceert zowel omlaag naar modellen en data als omhoog naar de applicatielaag. Wie de orkestratie slecht ontwerpt, merkt dat dit de flexibiliteit van de hele stack beperkt.
Welke laag is het meest kritisch voor productie-AI?
Voor productie-AI is de datalaag het meest kritisch. Een slecht gestructureerde of onbetrouwbare datapipeline ondermijnt de kwaliteit van elk model, ongeacht hoe geavanceerd dat model is. Garbage in, garbage out is in productieomgevingen geen cliché maar een dagelijkse realiteit.
Dat gezegd hebbende, verschuift de kritische laag afhankelijk van de volwassenheid van het systeem. Bij vroege prototypes is de modellaag vaak het knelpunt. Zodra een systeem in productie gaat, worden datakwaliteit, monitoring en de robuustheid van de orkestratielaag de dominante risicofactoren.
Technische teams onderschatten ook regelmatig de applicatielaag. Hier wordt bepaald hoe AI-uitkomsten worden vertaald naar zakelijke beslissingen. Een model dat technisch goed presteert maar verkeerd is geïntegreerd in bedrijfsprocessen, levert geen waarde op en ondermijnt het vertrouwen in de technologie.
Hoe pas je de 5-layer AI stack toe in een bestaand softwareproject?
De 5-layer AI stack toepassen in een bestaand project vraagt om een gelaagde aanpak: begin met inventariseren wat er al is, identificeer waar AI waarde toevoegt, en introduceer de stack incrementeel zonder de bestaande architectuur te destabiliseren.
- Audit de bestaande datainfrastructuur. Breng in kaart welke data beschikbaar is, in welke kwaliteit en via welke pipelines. Dit is de fundering van laag 1.
- Definieer de AI-usecase scherp. Welk probleem los je op? Codegeneratie, anomaliedetectie, documentverwerking? De usecase bepaalt welk model je nodig hebt in laag 2.
- Ontwerp de orkestratielaag modulair. Gebruik een agent-framework of prompt-orchestratietool die uitbreidbaar is, zodat je later modellen of databronnen kunt wisselen zonder alles te herschrijven.
- Integreer via de applicatielaag, niet via de interface. Koppel AI-functionaliteit aan bestaande bedrijfslogica via interne API’s. Zo blijft de interface stabiel terwijl de onderliggende AI-logica evolueert.
- Introduceer monitoring vanaf dag één. Voeg observability toe aan elke laag: log model-inputs en -outputs, meet latency, en stel drempelwaarden in voor datakwaliteit.
Een veelgemaakte valkuil is beginnen bij laag 5, de interface, omdat dat het meest zichtbare resultaat oplevert. Dat leidt tot AI-functionaliteit die indrukwekkend oogt maar niet schaalbaar of betrouwbaar is in productie.
Welke tooling hoort bij elke laag van de AI stack?
Per laag van de AI stack bestaat er een eigen gereedschapskist. De keuze voor specifieke tools hangt af van de schaal, het team en de bestaande technologiestack, maar onderstaand overzicht geeft een representatief beeld van gangbare opties in 2026.
- Datalaag: dbt, Apache Airflow, Spark, Snowflake, Databricks, of eenvoudigere opties zoals PostgreSQL met een ETL-pipeline voor kleinere projecten.
- Modellaag: Hugging Face Transformers, OpenAI API, Anthropic Claude API, Vertex AI, Azure ML of self-hosted open-source modellen zoals Mistral of LLaMA-varianten.
- Orkestratielaag: LangChain, LlamaIndex, CrewAI of Semantic Kernel voor agent-orkestratie; LangSmith of Weights & Biases voor prompt-monitoring.
- Applicatielaag: Standaard backend-frameworks (FastAPI, NestJS, Spring Boot) aangevuld met AI-specifieke middleware voor rate limiting, caching en foutafhandeling.
- Interfacelaag: Elke frontend-technologie die past bij het product: van een React-gebaseerde chat-UI tot een REST- of GraphQL-API voor systeem-tot-systeemcommunicatie.
Toolkeuze is geen doel op zich. Consistentie binnen een team en aansluiting bij bestaande expertise wegen zwaarder dan het adopteren van de nieuwste tool die op conferenties wordt gepresenteerd.
Wat zijn veelgemaakte fouten bij het opzetten van een AI stack?
De meest voorkomende fouten bij het opzetten van een AI stack zijn het overslaan van de datalaag, het ontbreken van laagscheiding, en het uitstellen van monitoring tot na de livegang. Elk van deze fouten vergroot de technische schuld exponentieel naarmate het systeem groeit.
Andere terugkerende problemen zijn:
- Vendor lock-in in de modellaag: Direct afhankelijk worden van één model-API zonder abstractielaag maakt het kostbaar om later van provider te wisselen.
- Orkestratie als monoliet: Alle prompt-logica, toolcalls en geheugenmanagement in één grote klasse of functie stoppen. Dit maakt testen en onderhoud vrijwel onmogelijk.
- Geen versioning van prompts: Prompts zijn code. Zonder versiebeheer is het onduidelijk waarom een model zich opeens anders gedraagt na een kleine aanpassing.
- Ontbreken van fallback-mechanismen: AI-modellen falen of geven onverwachte output. Een productiesysteem zonder graceful degradation is een risico voor de eindgebruiker.
Technische leiders die teams aansturen op AI-projecten doen er goed aan om deze risico’s expliciet te bespreken tijdens architectuurreviews, niet pas wanneer ze zich in productie manifesteren.
Wanneer is een volledige 5-layer stack de juiste keuze?
Een volledige 5-layer AI stack is de juiste keuze wanneer AI een structureel onderdeel wordt van het product en niet een eenmalig experiment. Concreet: als je verwacht dat het systeem meerdere AI-usecases gaat ondersteunen, in productie moet draaien met betrouwbaarheidsgaranties, of door meerdere teams tegelijk wordt doorontwikkeld.
Voor een prototype of proof of concept is een volledige stack vaak te zwaar. In die fase is het verstandiger om bewust te kiezen voor een lichtgewicht opzet die later uitbreidbaar is, in plaats van direct alle vijf lagen volledig uit te werken.
De afweging is eenvoudig: hoe groter de verwachte levensduur en schaal van het systeem, hoe meer de investering in een gelaagde architectuur zichzelf terugverdient. Wie nu snel iets bouwt zonder structuur, betaalt die rekening later met rente in de vorm van refactoring, downtime en verloren ontwikkelsnelheid.
Hoe SharpMinds helpt bij het bouwen van een solide AI stack
Een goed doordachte AI-architectuur valt of staat met de mensen die hem bouwen. Developers die AI-tools effectief inzetten, begrijpen niet alleen de tooling per laag, maar weten ook wanneer ze een AI-suggestie moeten vertrouwen en wanneer ze die naast zich neer moeten leggen. Dat oordeel ontwikkel je met ervaring, niet met een tutorial.
SharpMinds helpt softwaregedreven organisaties hun developmentteams uit te breiden met ervaren AI-native developers die praktische kennis hebben van de volledige AI stack. Concreet betekent dat:
- Developers die aantoonbaar werken met agent-frameworks, LLM-integraties en AI-gedreven codeertools
- Selectie op zowel technische diepgang als het vermogen om in een bestaand team en een bestaande architectuur te stappen
- Nearshore-samenwerking vanuit Europa, met maximaal één uur tijdsverschil voor directe communicatie
- Volledige HR-ontzorging, zodat jij je richt op de technische richting en niet op contracten of personeelsbeheer
Wil je weten welke profielen passen bij jouw AI-projecten? Neem contact op voor een vrijblijvend gesprek over de mogelijkheden.
Veelgestelde vragen
Hoe lang duurt het gemiddeld om een volledige 5-layer AI stack operationeel te krijgen?
De doorlooptijd varieert sterk afhankelijk van de bestaande infrastructuur en de complexiteit van de usecase. Voor een team met een volwassen datainfrastructuur en duidelijke usecase is een eerste werkende versie in vier tot acht weken haalbaar, maar een productie-waardige stack met monitoring, fallbacks en laagscheiding vraagt eerder drie tot zes maanden. Plan iteratief: breng eerst laag 1 en 2 op orde voordat je tijd investeert in een geavanceerde orkestratielaag.
Kan een klein team van twee of drie developers een volledige AI stack beheren?
Ja, maar dan is toolkeuze des te belangrijker. Kleine teams profiteren van managed services per laag — denk aan een cloud-gehoste datapipeline, een API-gebaseerd model en een lichtgewicht orchestratieframework — zodat de operationele last beperkt blijft. De valkuil voor kleine teams is over-engineering: kies voor eenvoud en uitbreidbaarheid boven volledigheid, en schaal de complexiteit mee met de groei van het systeem.
Hoe test je de verschillende lagen van de AI stack afzonderlijk?
Elke laag vraagt om een eigen teststrategie. De datalaag test je met datakwaliteitschecks en pipeline-validaties (bijvoorbeeld via Great Expectations of dbt tests). De modellaag test je met evaluatiesets en outputvergelijkingen tussen versies. De orkestratielaag test je met unit tests op individuele tools en integraties, en de applicatielaag test je zoals je elke backend test: met geautomatiseerde API-tests en contract testing. Door lagen te isoleren, kun je regressions per laag opsporen zonder de volledige stack te hoeven draaien.
Wat is het verschil tussen de orkestratielaag en de applicatielaag, en waarom is die grens belangrijk?
De orkestratielaag beslist hóé modellen worden aangeroepen: welke tools beschikbaar zijn, in welke volgorde stappen worden uitgevoerd, en hoe context wordt beheerd. De applicatielaag bepaalt wát er met de uitkomst gebeurt: hoe een AI-antwoord wordt verwerkt, opgeslagen of doorgestuurd naar een ander systeem. Die grens is cruciaal omdat het vermengen van orkestratie- en bedrijfslogica leidt tot code die moeilijk te testen en te hergebruiken is. Houd de orkestratielaag AI-specifiek en de applicatielaag domeinspecifiek.
Hoe ga je om met het feit dat LLM-outputs niet deterministisch zijn in een productiesysteem?
Niet-determinisme in LLM-outputs vraagt om defensief ontwerp op de applicatielaag: valideer outputs op structuur en inhoud voordat je ze doorgeeft aan andere systemen, gebruik gestructureerde outputformaten (zoals JSON-schema's of function calling) om variatie te beperken, en implementeer fallback-logica voor gevallen waarin de output buiten verwachte grenzen valt. Aanvullend helpt het om een evaluatiepipeline in te richten die periodiek steekproefsgewijs outputs beoordeelt, zodat modelgedrag over tijd inzichtelijk blijft.
Moet elke laag in dezelfde programmeertaal of hetzelfde framework worden gebouwd?
Nee, en dat is juist een van de voordelen van een gelaagde architectuur. De datalaag kan draaien op Python-gebaseerde pipelines, terwijl de applicatielaag in TypeScript of Java is gebouwd en de interfacelaag een React-frontend heeft. Zolang lagen communiceren via goed gedefinieerde interfaces — REST API's, message queues of interne SDK's — is de technologiekeuze per laag onafhankelijk. Beperk die vrijheid wel bewust: te veel technologiediversiteit vergroot de operationele complexiteit en de kennisdrempel voor nieuwe teamleden.
Hoe weet je wanneer het tijd is om de architectuur van je AI stack te herzien?
Er zijn vier duidelijke signalen: ten eerste wanneer het toevoegen van een nieuwe AI-usecase onbedoeld bestaande functionaliteit breekt, ten tweede wanneer debuggen van productie-issues meer dan een dag kost omdat de oorzaak niet per laag te isoleren is, ten derde wanneer het wisselen van model of dataprovider een grootschalige refactoring vereist, en ten vierde wanneer nieuwe teamleden weken nodig hebben om de codebase te begrijpen. Deze signalen wijzen op onvoldoende laagscheiding en zijn het moment om een gerichte architectuurreview in te plannen.
Gerelateerde artikelen
- Hoe gebruik je AI-agents voor geautomatiseerde softwaretests en debugging?
- Hoe zorgt AI-native development voor betere schaalbaarheid van softwareoplossingen?
- Hoe bouw je vertrouwen op met een nearshore team op afstand?
- Hoe bepaal je of nearshoring past bij jouw IT-organisatie?
- Hoe voorkom je vendor lock-in bij een nearshore samenwerking?